台灣科技週刊|Physical AI 深度分析 資料查核截至:2026 年 11 月 13 日
NVIDIA 本週發表的 GR00T 2,是目前公開資料最完整的機器人基礎模型之一:它用 40 萬小時以上的人類第一人稱影片預訓練,每個新任務給五次示範、做 30 分鐘微調,50 個未見過任務的平均成功率達 95%。這件事重要,因為它把「教機器人一個新動作」的成本壓到幾分鐘的資料,產線導入的瓶頸開始從訓練轉向驗收。
但 95% 不等於可以上線。同一組實驗裡,50 個任務中有 37 個做到每次試驗都成功,代表仍有 13 個任務會失手;NVIDIA 也沒有公布每個任務試了幾次。讀這類數字,需要先分清楚它量的是哪一種成功。
NVIDIA 這週發表的 GR00T 2 是什麼?
GR00T 2 是 NVIDIA 為機器人推出的新一代基礎模型,同時預測「接下來畫面會怎麼變」與「機器人該怎麼動」。
基礎模型指先用大量通用資料預訓練、再針對特定任務微調的大型 AI 模型。NVIDIA 把 GR00T 2 稱為「世界動作模型」(world action model,WAM):世界模型是能預測環境下一步變化的 AI,動作模型則輸出機器人的動作,GR00T 2 把兩者合在同一個擴散變換器(diffusion transformer)裡。依 NVIDIA GEAR 實驗室的研究頁,它的運作是一個迴圈:讀入最近的影像、文字指令與機器人狀態,同時「去噪」生成未來畫面與一段動作,執行這段動作後再重來一次;每種機器人只需要一個小型輸出頭,把共用的預測轉成各自的馬達指令。
發表場合是 11 月 9 日在美國德州奧斯汀舉行的機器人學習會議(Conference on Robot Learning,CoRL)。同場 NVIDIA 也發表開源機器人學習框架 Isaac Lab 3.0,其 GitHub 版本 v3.0.0 已在 10 月 20 日標為正式版;NVIDIA 稱,在一項以視覺為基礎的靈巧操作基準上,搭配開源物理引擎 Newton 的 Isaac Lab 3.0,訓練吞吐量最高是 Isaac Lab 2.3 搭配 PhysX 的 2.5 倍。
GR00T 2 還不能下載。研究頁寫明程式碼「12 月提供」,沒有提到模型權重與授權條款。NVIDIA 官方部落格列出的測試者包括鴻海(應用於伺服器製造的工廠自動化)、西門子(工業用途)與做洗衣機器人的 Nexuni。科技媒體 TNW 指出,這三家都還沒有表示會用於正式生產。
GR00T 2 和一年半前的 GR00T N1 差在哪?
最大的差別是資料來源與評測方式:N1 靠合成資料補量,GR00T 2 改以人類影片為主,並公布了大量實機成績。
|
項目 |
GR00T N1 |
GR00T 2 |
|---|---|---|
|
發表時間與場合 |
2025-03-18,GTC |
2026-11-09,CoRL |
|
架構 |
雙系統:視覺語言模型負責規劃,另一個快速模型轉成連續動作 |
單一擴散變換器同時生成未來影像與動作,各機器人共用 |
|
主要資料 |
11 小時生成 78 萬條合成軌跡,相當於 6,500 小時人類示範 |
人類第一人稱影片 402,730 小時、手持夾爪示範 10,184 小時、機器人遙控操作 23,500 小時 |
|
公司自述的代表成績 |
合成加真實資料比只用真實資料提升 40%(未說明任務與指標) |
50 個新任務:零示範平均 40%、1 次示範 71%、5 次示範 95% |
|
機上延遲 |
新聞稿未提供 |
2B 參數的 Turbo 版在 Jetson Thor 上 124 毫秒 |
|
開放程度 |
發表時即可取得 |
程式碼 12 月提供;授權未說明 |
資料日期:N1 為 2025 年 3 月 18 日新聞稿;GR00T 2 為 2026 年 11 月 9 日 NVIDIA 部落格與 GEAR 研究頁。
依研究頁的數字推算,GR00T 2 預訓練資料中,人類影片約占總時數的 92%,機器人遙控操作只約 5%。NVIDIA 對外開放其中 10 萬小時,命名為 Human-1M-100K。研究頁的一項實機實驗顯示了這個選擇的理由:在名為 Dexter 的雙手機器人上做 72 個任務,人類影片在訓練資料中的比例從 0 拉到 100%,任務進度從 50% 升到 70%。
本刊認為,這是 GR00T 2 最值得記住的新事實,比任何單一成功率都重要。機器人資料一直是 Physical AI 最貴的原料,要有人戴著設備一個動作一個動作遙控;如果人類拍攝的日常影片能替代其中大部分,資料的取得方式就從「租機器人和操作員」變成「付錢請人錄影」。TNW 也提到,已有新創付費請人拍攝做家事的影片當訓練資料。
71% 和 95% 該怎麼讀?什麼是成功率三把尺?
成功率三把尺是本刊提出的閱讀框架:同一組機器人實驗,至少要分成「一次」「平均」「次次」三種成功來看,因為它們分別回答研究、訓練成本與產線三個不同的問題。
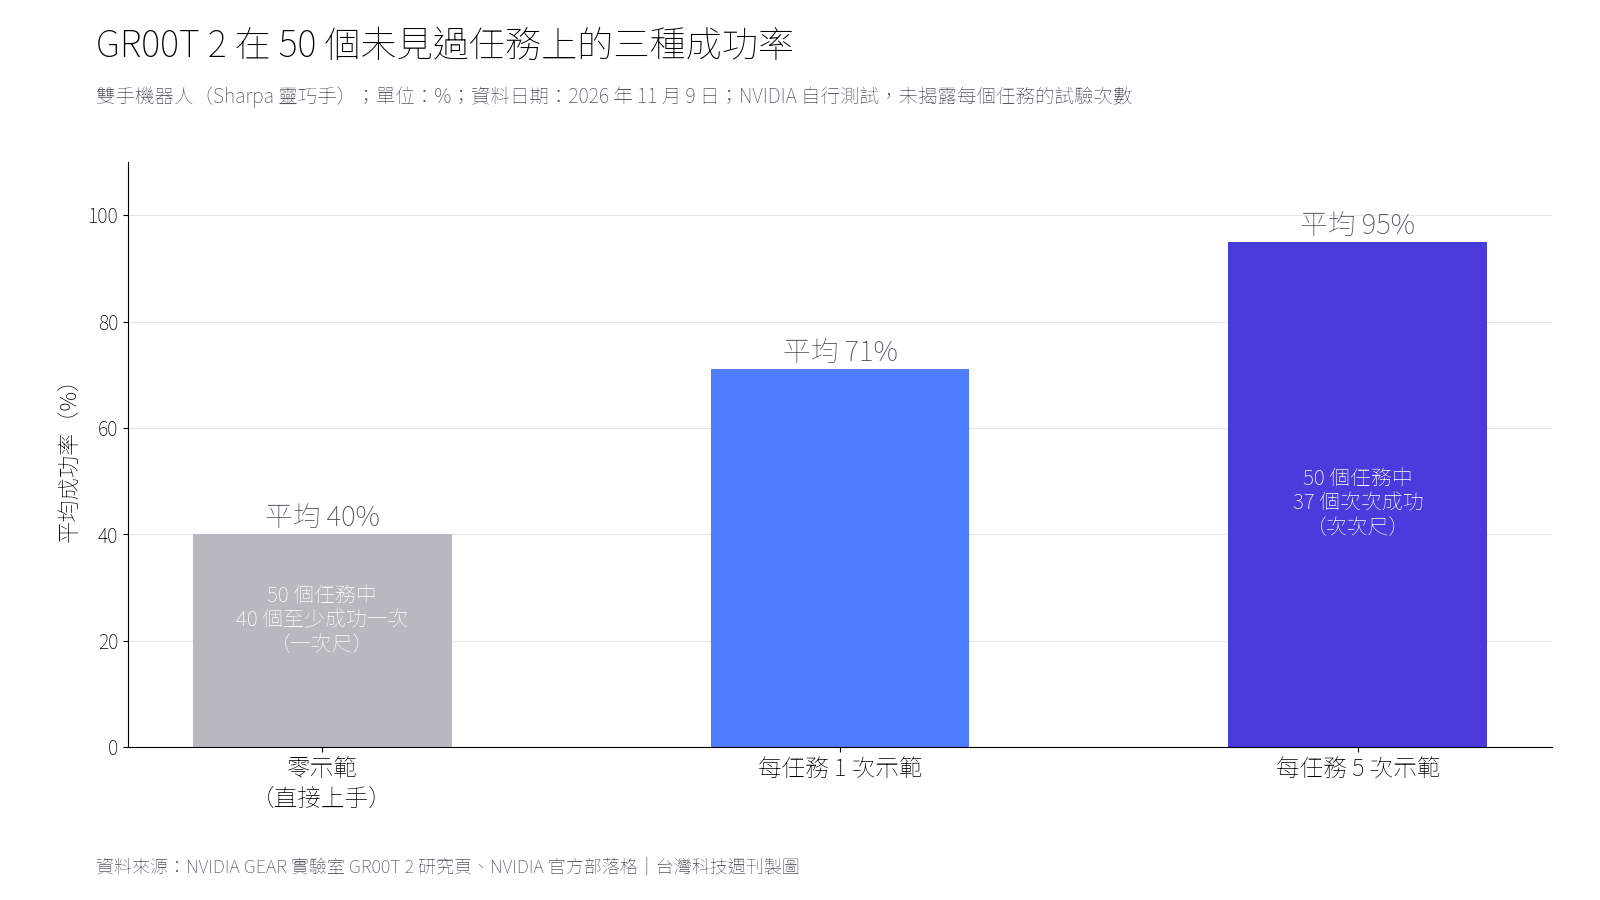
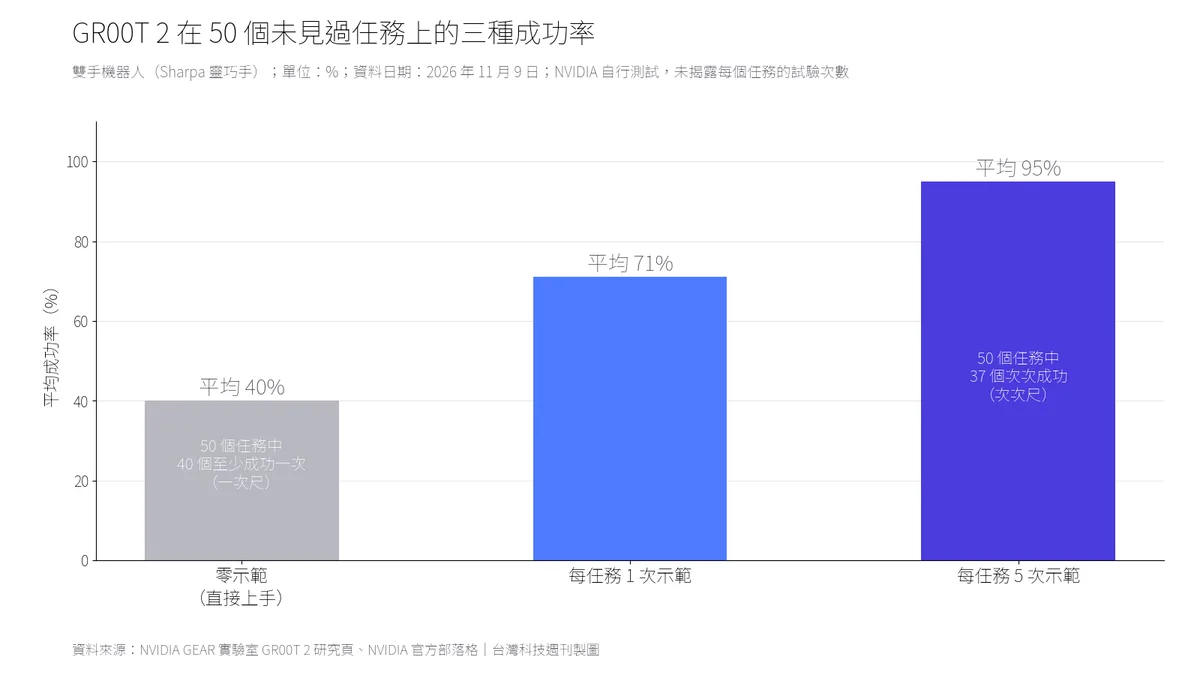
一次尺問的是:這個任務做不做得到?只要多次試驗中成功過一次就算。GR00T 2 在零示範下,50 個任務有 40 個至少成功一次。這把尺適合判斷模型的能力邊界,是研究者最關心的數字。
平均尺問的是:平均做得多好?它把所有試驗的成功率平均起來。GR00T 2 零示範平均 40%、1 次示範 71%、5 次示範 95%。這把尺最適合衡量「教一個新任務要多少資料」,也最常出現在標題上。
次次尺問的是:能不能放著它自己做?只計算每次試驗都成功的任務。5 次示範後,50 個任務中有 37 個次次成功,占 74%。這是工廠真正需要的數字,卻最少被報導。
三把尺會給出不同的印象。用平均尺看,GR00T 2 已經到 95%;用次次尺看,四分之一的任務仍會在某次試驗失手。兩個數字都正確,只是回答不同問題。
讀這組數字還有兩個限制。第一,研究頁只給彙總結果,沒有說明每個任務的試驗次數;若每個任務只試幾次,「次次成功」的門檻就不高。第二,TNW 引述 NVIDIA 的論文指出,這 50 個測試任務是從模型本來就學得好的任務中挑選,結果能推廣多遠有限。本刊沒有取得論文全文,此點為單一來源轉述。
本刊建議,任何機器人廠商或模型公司公布成功率時,讀者都可以追問三件事:這是哪一把尺?每個任務試了幾次?測試任務怎麼挑的?三個問題答不出來,數字就只能當展示。這與本刊先前提出的人形機器人 PAID 四問可以搭配使用:PAID 問的是「算不算部署」,三把尺問的是「實驗數字能不能拿來推估部署」。
為什麼 95% 還不夠上產線?
因為產線的工站通常是一連串步驟,單步成功率會連乘縮水;95% 的單步成功率,連做 10 步只剩約 60% 能一次做完。
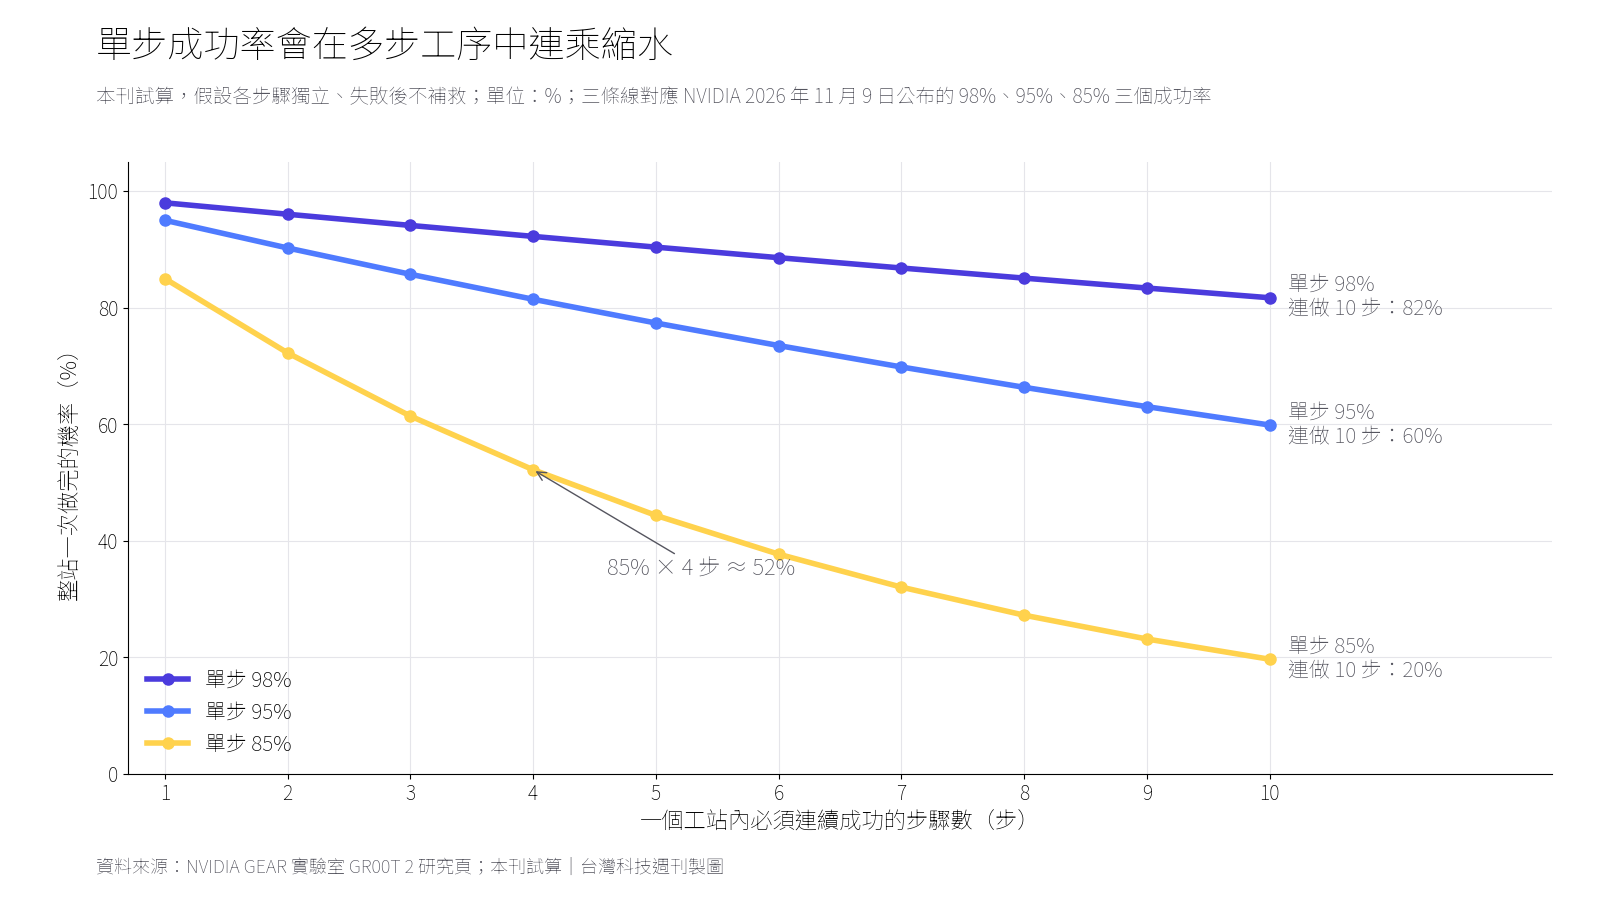
這是本刊依機率的簡單試算,假設各步驟彼此獨立、失敗後不補救。以研究頁列出的 GB300 記憶體模組安裝為例,GR00T 2 用兩隻 22 自由度的 Sharpa 靈巧手做到 85% 成功率。若某工站要連續裝 4 條模組,整站一次做完的機率約 52%;連裝 8 條約 27%,連做 10 步只剩約 20%。單步 95% 時,連做 5 步約 77%、10 步約 60%;單步要到 98%,10 步才能維持約 82%。
真實工序不會完全符合這個假設。有些失敗會連鎖,有些可以重來;研究頁也沒有說明 85% 是單條模組還是整組安裝的成功率。但方向很清楚:在示範影片裡看起來「幾乎都成功」的單一動作,放進多步驟工站就會被放大成明顯的停線風險。
這也說明為什麼工業機器人過去能在產線普及:傳統工業機器人在固定治具、固定位置下重複同一動作,單步可靠度極高,換線卻很昂貴。GR00T 2 這類模型的賣點正好相反,換任務便宜,單步可靠度還在追。兩者的取捨,就是產線導入要算的帳。
讓機器人自己檢查與補救,能補上可靠度嗎?
可以補上一大段。GR00T 2 研究頁最接近產線需求的數字,不是模型本身,而是外面包一層「代理」之後的結果。
代理(agent)指能自行規劃步驟、呼叫工具並檢查結果的 AI 系統。研究頁描述的做法是讓代理執行「觀察、推理、行動、驗證」的迴圈,把 GR00T 2 當成工具呼叫;零件掉落或進度停滯時,代理會先用另一套技能把現場復原,再把控制權交回。
在 YAM 機械手臂組裝玩具的實驗中,每種玩具各試 100 次,加上代理後,飛機 98 次成功、拖拉機與玩具車各 97 次,300 次中成功 292 次。同一個後訓練模型不加代理時成功 71 到 84 次,只做監督式後訓練則是 23 到 69 次。另一組串接任務中,使用經強化學習後訓練的技能,插 5 條網路線的成功從 20 次中 12 次升到 19 次,插 5 個充電器從 2 次升到 20 次。研究頁另外列出三個接觸密集的實機任務,以強化學習自我模仿後,成功率從 40% 至 76% 提高到 88% 至 96%。
本刊認為,這組數字透露了一個方向:機器人的可靠度,未來可能更多來自系統層的「檢查與補救」,而不只是模型本身變強。這和軟體界的經驗類似,程式代理寫得快,瓶頸卻落在驗收,本刊在程式代理與驗收帶寬一文討論過同樣的結構。
代理也帶來新的風險。會自己決定重試與補救的系統,失敗時更難追查是哪一層出錯;在實體世界裡,錯誤的「補救」可能損壞零件或碰撞人員。本刊在AI Agent 的安全盲點談過軟體代理的權限問題,搬到機器人身上,問題只會更實體。工廠評估時,該要求供應商把「代理介入幾次、補救花了多少時間」與成功率一起公布。
教一個新任務要多少資料與算力?
依 NVIDIA 自述,很少:五次示範對應不到 3 分鐘的機器人資料,在單張 RTX 5090 顯示卡上做 30 分鐘的 LoRA 微調,就能從零示範的平均 40% 拉到 95%。
LoRA(低秩適應)是一種只調整模型少量參數的微調方法,成本遠低於重新訓練整個模型。若這個數字能在更多任務上重現,對工廠的意義是:換線時「教機器人」的成本,可能從過去的數週工程與大量遙控資料,縮短到一位技術員示範幾次、一台工作站跑半小時。
推論延遲也已接近實用。研究頁指出,2B 參數的 GR00T 2 Turbo 在 Unitree G1 人形機器人搭載的 Jetson Thor 上預測一次約 124 毫秒,在 RTX 5090 上 38 毫秒;它大約每秒規劃一段 1.6 秒長的動作,底層控制器以每秒 50 次運作。Turbo 版在 G1 上的實機成績包括:舀爆米花並端上桌 48 次全部成功,清理擺滿雜物的桌面 30 次中成功 93%。
本刊認為,訓練成本一旦下降,產線導入的新瓶頸會是「誰來驗收」。每教一個新任務,都需要有人設計測試、跑足夠多次、判定它是否達到次次尺的標準。驗收的人力與時間,可能比訓練本身更貴。
模擬評測能取代實機測試嗎?
還不能取代,但已能拿來排序。NVIDIA 在 25 個 YAM 機械手臂任務上,比較 14 個 GR00T 2 策略在模擬與實機的成功率,兩者的皮爾森相關係數為 0.92。
相關係數 0.92 代表模擬裡表現較好的策略,到了實機通常也較好,可以用模擬先篩掉明顯較差的版本,省下實機測試的時間。但相關高不代表數值相等,模擬成功率仍不能直接當作產線數字。
這也是 NVIDIA 本週同時推出評測工具的原因。開源評測框架 Isaac Lab-Arena 0.4 以開發者預覽版釋出;南韓新創 RLWRLD 與 NVIDIA 合作的 DexBench 涵蓋零售、物流、製造與服務業四個場景、15 個任務;UC Berkeley 與 NVIDIA 的 VABAR 則在六個工業任務上設定標準化的變化與難度分級。本刊認為,機器人產業的下一個競爭點,可能是誰定義「怎麼算成功」:評測基準一旦被廣泛採用,它採用的尺,就會決定廠商報告哪個數字。
台灣的伺服器產線離用上它還有多遠?
鴻海是 NVIDIA 本週點名的 GR00T 2 測試者,用途是伺服器製造的工廠自動化;但目前公開資訊只到測試與小規模部署,還沒有量產導入的證據。
時間軸可以拼出來。工商時報 3 月報導,鴻海在 NVIDIA GTC 2026 首次在美國公開與 NVIDIA 合作開發的 AI 工業人形機器人細節,可執行取放、鎖螺絲與物料搬運,訓練結合模擬與現場迭代,使用 Isaac GR00T、Isaac Sim 與 Jetson Thor。製造業媒體 Build Better 4 月報導,鴻海一位資深機器人工程師在 GTC 表示,計畫 4 月中在休士頓廠的伺服器產線部署「不到 10 台」人形機器人,協助組裝 NVIDIA GB300 AI 伺服器,機型是輪式底座、固定夾爪,並會依任務更換末端工具;但他也說「沒有時程表」,鴻海拒絕進一步評論部署規模。本刊未查到 4 月之後的部署成效。
同一篇報導中,台灣機器視覺業者所羅門(Solomon)的業務主管估計,人形機器人要在真實環境中完全發揮功能,大約還需要三年,理由是硬體限制與模擬和真實物理之間的落差。
把三把尺套到台灣伺服器組裝,可以看出幾個判斷。
第一,研究頁列出的 GB300 記憶體模組安裝 85%,正是伺服器產線的實際工序,但本刊未查到這項實驗與鴻海有關,不能把它解讀為鴻海的產線成績。
第二,伺服器組裝屬於「多步驟、高單價、低容錯」的工序,次次尺比平均尺重要得多。一片主機板裝壞的損失,遠高於倉庫裡掉一個紙箱。
第三,台灣 AI 伺服器製造業者若要評估這類模型,最務實的做法不是看發表會影片,而是在自家工站上量三把尺,加上代理介入次數與補救時間。這些數字目前只有模型供應商自己公布,產線端的第一手數據,反而是台灣製造業者最有機會率先掌握、也最有議價力的資產。
本刊也要提醒:鴻海名列測試者,不等於台灣供應鏈已有相關訂單或營收。本刊未查到任何台灣企業公布與 GR00T 2 相關的採購或量產計畫。
這些數字有哪些還不能當真?
本文引用的 GR00T 2 成績幾乎全部來自 NVIDIA 自行測試,目前沒有獨立評測。
具體的保留包括:研究頁未揭露 50 個任務各自的試驗次數;TNW 引述論文指出測試任務經過挑選;研究頁對部分實驗沒有明確說明是實機或模擬;GB300 模組安裝 85% 沒有試驗次數與定義;程式碼 12 月才提供,外界還無法重現。媒體標題常引用的「40 個任務至少成功一次」,用三把尺來看屬於一次尺,量的是能力範圍,不是重複可靠度。
另一個值得注意的落差,是 NVIDIA 部落格與研究頁對人類影片資料的描述:部落格說訓練資料「包括 10 萬小時開源的人類第一人稱資料」,研究頁則說預訓練用了 402,730 小時,其中 10 萬小時開源。兩者不矛盾,但只看部落格會低估資料規模。
接下來要盯哪些訊號?
未來幾個月有四個節點可以檢驗本文的判斷。
第一是 12 月的程式碼釋出,要看模型權重是否一併開放、授權是否允許商業使用,這決定台灣廠商能不能在自家工站上自行量三把尺。第二是 DexBench、VABAR 等第三方評測的首批結果,看 GR00T 2 在非 NVIDIA 自選的任務上表現如何。第三是鴻海休士頓廠,是否公布人形機器人部署的台數變化、工站類型或介入率。第四是其他模型公司是否跟進公布「次次成功」這類可靠度指標。
本刊的判斷是:GR00T 2 讓「教機器人一個新任務」變便宜了,但產線要的不是平均 95%,而是次次成功,外加一套說得清楚失敗時發生什麼事的補救機制。當模型公司開始把次次尺放在平均尺前面公布,機器人基礎模型才算真正走進工廠的語言。
|台灣科技週刊
資料與方法說明
本文 GR00T 2 的技術規格與實驗數字,主要來自 NVIDIA 官方部落格與 NVIDIA GEAR 實驗室的 GR00T 2 研究頁,均為公司自述,尚無獨立評測;研究頁所附白皮書全文本刊未取得。TNW 關於「測試任務經挑選」的說法,為該媒體引述論文的單一來源。鴻海休士頓廠「不到 10 台」人形機器人的資訊來自 Build Better 4 月的報導,本刊未查到之後的部署成效。所羅門的公司身分係本刊依報導中的公司名稱判斷。
「成功率三把尺」與多步驟工序的連乘試算為本刊分析。連乘試算假設各步驟獨立、失敗不補救,僅用來說明方向,不代表任何實際產線的良率。人類影片占預訓練資料約 92%、遙控操作約 5%,為本刊依研究頁三項時數加總推算。
參考資料
- NVIDIA,〈Practice Makes Precise: At CoRL, NVIDIA and Partners Reveal How Robots Rehearse Delicate Work in Simulation〉,2026-11-09。
- NVIDIA GEAR Lab,〈GR00T 2: Scaling Robot Foundation Models for Generalization, Dexterity, and Adaptation〉,2026-11。
- The Robot Report,〈NVIDIA launches GR00T 2 and Isaac Lab 3.0 at CoRL〉,2026-11-09。
- The Next Web,〈Nvidia's GR00T 2 teaches robots delicate skills from human video〉,2026-11-09。
- isaac-sim,〈Isaac Lab Releases(v3.0.0)〉,2026-10-20。
- NVIDIA,〈NVIDIA Announces Isaac GR00T N1 — the World's First Open Humanoid Robot Foundation Model — and Simulation Frameworks to Speed Robot Development〉,2025-03-18。
- Build Better(Instrumental),〈Foxconn's Humanoid Push Will Start Small in Houston, Engineer Says〉,2026-04-20。
- 工商時報,〈《其他電》GTC大會 鴻海秀深度合作科技實力〉,2026-03-17。