台灣科技週刊|AI 深度分析 資料查核截至:2026 年 11 月 13 日
四家主要 AI 公司 10 月 30 日同日表態,將支援一個寫在 robots.txt 裡的共同代號 __usage_ai-training,網站只要寫一組規則,就能同時向多家業者表達「不同意拿內容訓練生成式 AI」。這件事重要,是因為出版商過去得逐家封鎖 GPTBot、ClaudeBot、Google-Extended 等不同代號,新訊號第一次讓「拒絕訓練」有了跨業者的寫法。
但流傳的說法「一行就能擋掉四大 AI」並不精確。實際情況是:Anthropic 自述已開始實作、正逐步推廣到所有服務;OpenAI 只說未來幾個月;Google 說 2027 年;微軟訂在 2027 年 2 月 1 日。這個代號也不是正式標準,而是 Anthropic 工程師 Kevin Kelley 以個人名義提交的網際網路草案。本週,IETF 工作小組的郵件論壇上,主席提醒代號名稱可能還會改,News Corp 與歐洲出版商理事會的代表則公開表示不支持或質疑程序。
本刊的判斷是:AI 公司對網站內容的使用,實際上由三個開關控制——抓取開關、訓練開關、回答開關,而四家公司把這三個開關接成了四種不同的線路。 本刊稱之為「三開關、四種接線」。新代號只統一了中間那個訓練開關,而且只是「沒有具名規則時」才生效的預設值。台灣內容網站如果不先弄清楚自己現有規則接在哪條線上,加了這一行,可能擋不到想擋的,或者擋到不想擋的。
四大 AI 公司支持的是什麼標準?
答案是一份名為〈Machine-Readable Training Preference Signal〉(機器可讀的訓練偏好訊號)的網際網路草案,編號 draft-kelley-aipref-training-preference-signal-00,2026 年 10 月 30 日提交,作者是 Anthropic 的 Kevin Kelley。
先釐清幾個名詞。IETF(網際網路工程任務組)是制定 HTTP 等網際網路協定的標準組織;網際網路草案(Internet-Draft)是提交給 IETF 討論的工作文件,有效期六個月,本身不具標準地位。robots.txt 是網站放在根目錄、告訴爬蟲哪些路徑可以抓的文字檔,2022 年由 IETF 正式寫成 RFC 9309(機器人排除協定)。
這份草案在 IETF 資料庫的狀態是「個人提交」,不是工作小組文件,2027 年 5 月 3 日到期。它在 AIPREF 工作小組(AI Preferences,AI 使用偏好工作小組)的郵件論壇上討論。AIPREF 於 2025 年 1 月成立,主席是 Mark Nottingham 與 Suresh Krishnan,目前正式採納的工作文件有兩份:一份定義「AI 訓練」「AI 使用」「搜尋」等用途詞彙,另一份規定如何把偏好掛到 robots.txt 與 HTTP 標頭上。
值得注意的是,連那份詞彙草案(第 08 版)的開頭都寫明,內容尚未反映工作小組共識,只是討論基礎。Kelley 草案直接借用其中「AI 訓練」的定義:用一項資料去改變生成式 AI 模型的學習參數。只用於分類、排序、評分等非生成任務的模型訓練不算在內。
四家公司的支持方式並不相同。Kelley 10 月 30 日在 IETF 郵件論壇宣布草案時表示,Anthropic 已開始實作,但要擴及所有服務需要時間。Google 搜尋倡議者 John Mueller 同日在 Google 搜尋中心部落格發文,說將與其他 AI 業者在 2027 年支援;Google 的爬蟲說明文件則寫「2027 年初」。微軟 Bing 產品經理 Krishna Madhavan 同日發文,列出 2027 年 2 月 1 日起依新偏好處理的時程。OpenAI 的公告頁面本刊無法開啟,依 Nieman Lab 與 SiliconANGLE 的報導,OpenAI 表示會在未來幾個月內支援。Meta 方面,Nieman Lab 引述其通訊副總裁 Andy Stone 的貼文稱這是重要一步;SiliconANGLE 則指 Meta 尚未承諾實作。
這行設定在技術上怎麼運作?
它借用 robots.txt 既有的「User-Agent 群組」寫法,但 User-Agent 後面寫的不是某支爬蟲的名字,而是一個代表用途的「政策代號」(policy token)。草案的示範如下:
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
這段的意思是:除了 /press-kit/ 底下的頁面,全站都表達「反對用於 AI 訓練」;/press-kit/ 則表達「同意」。判讀方式完全沿用 RFC 9309 的路徑比對與最長比對優先規則,所以草案強調它沒有引入任何新指令或新語法,不認得這個代號的舊程式會像忽略任何陌生爬蟲一樣忽略它。
草案有四條規則,決定了它實際上的效力範圍。
第一,萬用群組 User-Agent: * 不得被解讀為符合這個代號。換句話說,網站原本寫給所有爬蟲的規則,不會自動變成訓練偏好;要表達偏好,必須明寫這個代號。
第二,檔案裡如果完全沒有這個代號,代表網站「沒有表達任何偏好」,而不是同意或反對。
第三,它不是抓取指令。草案寫明,訓練偏好與流量管理是互相獨立的兩件事;爬蟲仍依自己的代號規則決定抓不抓。業者可以參考偏好決定少抓一些,但不是義務。
第四,具體的規則應優先於一般規則。業者可以聲明,自家專屬代號(例如 GPTBot、Google-Extended)的規則比共同代號更具體;雙方另有私下協議時,也可以蓋過這裡表達的偏好。
這四條合起來,就是本刊說它「是預設值、不是總開關」的原因:它只在網站沒有對某家業者寫具名規則時,才替那家業者決定訓練偏好。
它和 robots.txt 既有的爬蟲代號是什麼關係?
各家答案不同,而差異正好落在台灣網站最常寫的那幾行規則上。下表整理四家公司目前公開的處理方式。
|
業者 |
支援時程(自述) |
既有訓練控制 |
具名規則與共同代號衝突時 |
共同代號是否影響 AI 回答 |
|---|---|---|---|---|
|
Anthropic |
10 月 30 日起承認,逐步擴及所有服務 |
ClaudeBot |
以點名 ClaudeBot 的規則為準 |
草案定義只管訓練;Claude-SearchBot、Claude-User 另有代號 |
|
OpenAI |
未來幾個月(媒體轉述,原文未能開啟) |
GPTBot |
未能確認 |
未能確認;ChatGPT 搜尋由 OAI-SearchBot 控制 |
|
|
2027 年(部落格)/2027 年初(文件) |
Google-Extended |
明確寫了 Google-Extended 就以它為準 |
會:未寫 Google-Extended 時,視同封鎖 Google-Extended |
|
微軟 |
2027 年 2 月 1 日起 |
原為 NoArchive/NoCache 頁面標籤 |
頁面層級的訓練設定可覆蓋 robots.txt |
不會:AI 依據(grounding)另以頁面標籤設定 |
資料日期:2026 年 11 月 13 日。來源:Anthropic 說明中心、Google 搜尋中心部落格與爬蟲文件、微軟 Bing 部落格、Nieman Lab、SiliconANGLE。
Anthropic 的說明頁寫得最直接:robots.txt 如果直接點名 ClaudeBot,就照那條規則;沒點名,才適用共同訊號。依該頁說明,ClaudeBot 抓取的內容可能用於訓練,Claude-SearchBot 用於改善搜尋結果,Claude-User 則是在使用者提問時代為抓取頁面,三者各有代號。
Google 的處理最需要留意。Google 表示,網站用共同代號拒絕訓練、又沒有明寫 Google-Extended 時,Google 會當作網站封鎖了 Google-Extended。問題在於 Google-Extended 管的不只是訓練:依 Google 爬蟲文件,它同時控制內容能否用於 Gemini 應用程式與 Vertex AI 的「依據」(grounding,在生成回答時拿網頁內容當參考資料)。Google 在公告中也寫道,明確允許 Google-Extended 的網站,有資格出現在 Gemini 應用程式的回答,並透過依據獲得點擊。本刊依這兩份文件推論:只寫共同代號拒絕訓練、沒有另寫 Google-Extended 的網站,在 Google 開始支援後,可能也一併退出 Gemini 應用程式的回答來源。Google 文件同時說明,Google-Extended 不影響 Google 搜尋收錄與排名。
微軟則把訓練和依據明確拆成兩套獨立設定。robots.txt 的共同代號只管訓練;依據偏好只能用頁面標籤或 HTTP 標頭設定,分成允許、只限微軟自家服務、完全不允許三種。微軟表示,這兩種偏好都不影響 Bing 傳統搜尋結果的收錄資格,但選擇不允許依據,會降低品牌在 AI 體驗中的能見度。微軟也預設「允許」:網站不寫,就當作同意訓練。這一點和草案「沒寫就是沒有表達偏好」的措辭並不一致。
OpenAI 的部分,本刊只能確認其既有分工:依 OpenAI 爬蟲文件,GPTBot 抓取的內容可能用於訓練生成式基礎模型,OAI-SearchBot 決定網站能否出現在 ChatGPT 搜尋答案,兩者設定互相獨立;使用者觸發的 ChatGPT-User,文件寫明 robots.txt 規則可能不適用。這份文件截至本刊查核時尚未提到共同代號。
為什麼說它是預設值,不是總開關?
因為 AI 公司對一個網頁的使用分成三層,共同代號只碰得到中間一層,而且會被具名規則蓋過。
本刊把這三層稱為「三開關」。抓取開關決定爬蟲能不能把頁面抓回去,由各家爬蟲代號的 Allow/Disallow 控制,這是 RFC 9309 本來的功能。訓練開關決定抓回去的內容能不能拿來改變模型參數,過去由 GPTBot、Google-Extended 這類專屬代號兼管,現在多了共同代號。回答開關決定內容能不能在使用者提問時被即時取用、摘要或引用,由 OAI-SearchBot、Claude-SearchBot、微軟的依據標籤等控制。
「四種接線」指的是四家公司把這三個開關接在一起的方式各不相同:
- Anthropic 用三個爬蟲代號分開訓練、搜尋與使用者代抓,點名 ClaudeBot 的規則一律優先,共同代號只補位給沒點名的網站。
- OpenAI 同樣用 GPTBot 與 OAI-SearchBot 分開訓練與搜尋,封鎖 GPTBot 等於同時關掉抓取與訓練;但它如何處理共同代號與 GPTBot 衝突,目前沒有公開說明。
- Google 的 Google-Extended 把訓練開關和 Gemini 應用程式的回答開關接在同一條線上,共同代號又被對應到 Google-Extended,於是拒絕訓練可能連帶關掉 Gemini 應用程式的回答來源。
- 微軟把三者拆得最開,robots.txt 管訓練、頁面標籤管依據、Bingbot 管抓取,而且預設全部允許。
以為加了共同代號就能讓 AI 爬蟲不再造訪,就是把訓練開關誤當成抓取開關。過去本刊在〈被 AI 引用不等於有流量〉中整理過各家爬蟲在 AI 搜尋中的分工;這次的共同代號,則是在那張圖上再加一個只管訓練的開關。
標準還沒定案,誰在質疑?
本週 IETF 郵件論壇上的討論顯示,這個代號的名稱、定位與程序都還有爭議。
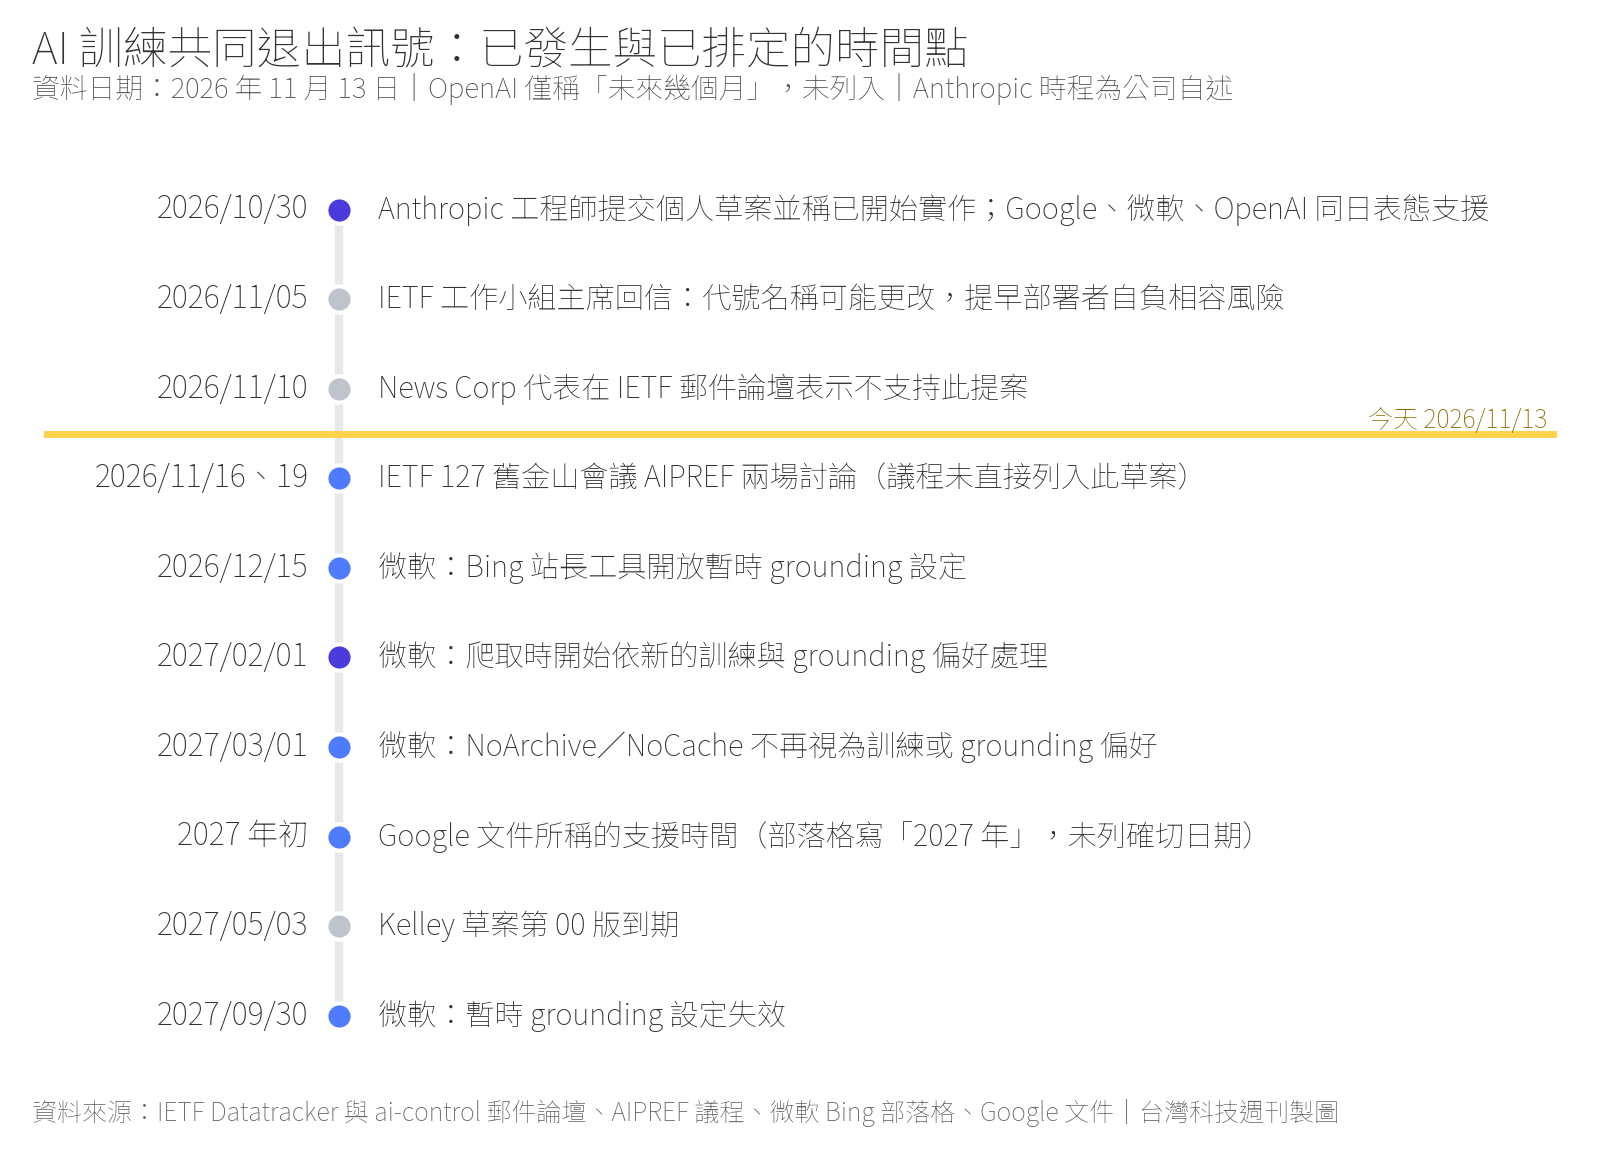
工作小組主席 Nottingham 11 月 5 日回信,代表兩位主席詢問這份草案是要取代現行的附掛草案,還是修改它。他認為只涵蓋訓練一個用途,很難取代涵蓋完整詞彙的方案;主席希望討論的是如何把整套詞彙對應到 robots.txt,而不是只處理其中一項。他也提醒,__usage_ai-training 不是最終形式,因為工作小組詞彙裡的對應標籤是 train-ai,兩者相近到可能讓網站管理者混淆,並建議改用 __usage_2026-ai-training 這類更有區別的名稱。他補充,提早部署很常見,但先部署的人要自行承擔與最終標準不相容的風險。
出版業的反應更直接。News Corp 的 Alex Gibson 11 月 10 日回信指出,草案致謝名單列出他與同事,但他們沒有參與這份草案,並寫明「News Corp does not support the proposal」(News Corp 不支持此提案),要求移除名字。歐洲出版商理事會的 Angela Mills-Wade 11 月 12 日也表示,公告搶在工作小組討論之前發出,並強調對出版商而言,搜尋和新聞內容被用於 AI 回答的區分特別重要,訓練只是其中一部分。
Kelley 11 月 11 日(美西時間)回應,致謝不代表背書,願意修改措辭或依要求移除姓名;他也說明這是個人草案,是工作小組成果的一個檢查點,不是工作小組的產物。旅遊網站創辦人 Nate Hake 則在 11 月 3 日的回信中表示,四家公司快速背書讓他措手不及,並轉述創作者的擔憂:這可能讓「選擇退出」成為著作權問題的常態解法。
另一個技術爭議是語法本身。同一個「不要拿去訓練」的意思,目前至少有三種寫法在流通:
|
寫法 |
提出者 |
範例 |
狀態(2026 年 11 月 13 日) |
|---|---|---|---|
|
政策代號 |
Kelley 個人草案(Anthropic) |
User-Agent: __usage_ai-training 加 Disallow: / |
個人草案;四家公司表態支援 |
|
Content-Usage 規則 |
AIPREF 工作小組附掛草案(作者來自 Google、Mozilla) |
Content-Usage: train-ai=n |
工作小組文件第 05 版 |
|
Content-Signal 規則 |
Cloudflare 內容訊號政策 |
Content-Signal: search=yes, ai-train=no |
Cloudflare 2025 年 9 月推出,替逾 380 萬個啟用代管 robots.txt 的網域加入 |
資料日期:2026 年 11 月 13 日。來源:IETF Datatracker、Cloudflare 部落格。
三者的差異不只是拼字。工作小組的 Content-Usage 寫在既有爬蟲群組裡,偏好跟著爬蟲走;Kelley 的政策代號自成一個群組,偏好跟著用途走;Cloudflare 的 Content-Signal 通常寫在萬用群組裡,而 Kelley 草案明定萬用群組不得對應到政策代號。本刊查閱的 Google、微軟、Anthropic 說明都以政策代號為對象,未見提到會把 Content-Signal 當成同一個訊號讀取。
依 AIPREF 公布的議程,IETF 127 舊金山會議的兩場討論排在 11 月 16 日與 19 日,議程沒有直接列出這份草案;主席另在調查是否於 2027 年 2 月召開期中會議。
台灣媒體的 robots.txt 現在怎麼寫?
本刊 11 月 13 日擷取 22 個台灣主要新聞與科技媒體的公開 robots.txt,其中 19 個取得有效檔案。結果是:沒有任何一站寫入 __usage_ai-training;10 站整站封鎖 GPTBot 與 ClaudeBot,但只有 3 站封鎖 Google-Extended。
|
網站 |
GPTBot |
ClaudeBot |
Google-Extended |
其他 AI 相關寫法 |
|---|---|---|---|---|
|
中央社 |
封鎖 |
封鎖 |
未列名 |
Content-Signal:ai-train=no |
|
iThome |
封鎖 |
封鎖 |
封鎖 |
Content-Signal:ai-train=no;註解引用歐盟著作權指令第 4 條 |
|
商業周刊 |
封鎖 |
封鎖 |
封鎖 |
明確允許 OAI-SearchBot、Claude-SearchBot |
|
報導者 |
封鎖 |
封鎖 |
封鎖 |
明確允許 OAI-SearchBot;註解列出禁止用途 |
|
自由時報 |
封鎖 |
封鎖 |
明確允許 |
|
|
中時新聞網 |
封鎖 |
封鎖 |
明確允許 |
也封鎖 OAI-SearchBot、ChatGPT-User |
|
聯合新聞網 |
封鎖 |
封鎖 |
未列名 |
註解聲明不得用於大型語言模型 |
|
科技新報 |
封鎖 |
封鎖 |
未列名 |
也封鎖 OAI-SearchBot、ChatGPT-User |
|
INSIDE |
封鎖 |
封鎖 |
未列名 |
|
|
關鍵評論網 |
封鎖 |
封鎖 |
未列名 |
|
|
ETtoday |
明確允許 |
明確允許 |
未列名 |
宣告 RSL 授權檔 |
|
三立新聞網 |
明確允許 |
明確允許 |
未列名 |
|
|
NOWnews |
未列名 |
未列名 |
明確允許 |
|
|
公視新聞網、鏡週刊、風傳媒、TVBS 新聞網、數位時代、今周刊 |
未列名 |
未列名 |
未列名 |
|
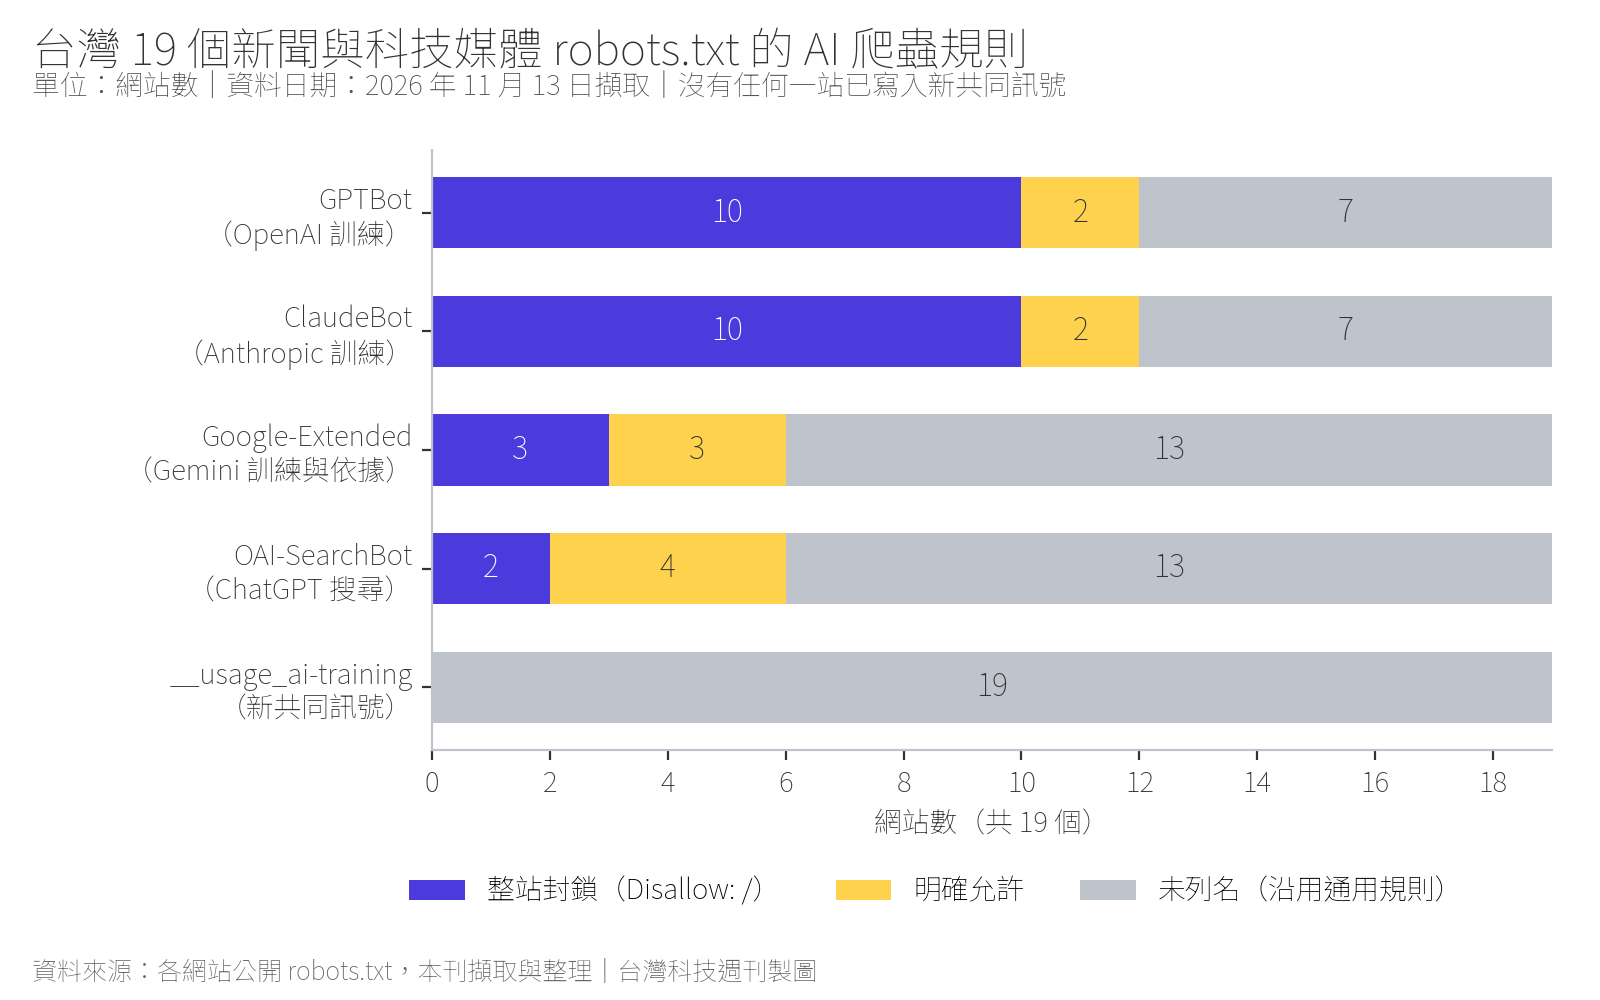
資料日期:2026 年 11 月 13 日擷取。天下雜誌回傳 403 錯誤,工商時報、遠見雜誌連線失敗,未列入。「未列名」表示沒有針對該代號的群組,適用網站的通用規則。
把這張表放回「三開關、四種接線」,可以看出新代號對台灣網站的實際影響。
已經逐家封鎖 GPTBot、ClaudeBot 的 10 站,對 Anthropic 而言,加不加共同代號差別不大,因為具名規則優先;OpenAI 的處理方式尚未公開,但這些網站本來就封鎖了 GPTBot。真正會改變的是兩家:一是微軟,它過去的訓練偏好靠頁面層級的 NoArchive/NoCache 標籤表達,這 19 站的 robots.txt 都沒有針對 Bingbot 的規則;二是 Google。
Google 這一塊又分兩種情況。自由時報與中時新聞網明確允許 Google-Extended,依 Google 的說法,明寫的設定優先,加了共同代號也不影響 Google。中央社、聯合新聞網、科技新報、INSIDE 與關鍵評論網則封鎖了 OpenAI 與 Anthropic,卻沒有寫 Google-Extended;這 5 站如果把共同代號當成「一行全擋」加上去,Google 開始支援後會視同封鎖 Google-Extended,連帶影響 Gemini 應用程式的回答來源。這可能正是它們要的,也可能不是,但應該是有意識的選擇。
反方向的陷阱在 ETtoday 與三立新聞網。兩站明確允許 GPTBot 與 ClaudeBot 抓取;依 Anthropic 的說明,點名 ClaudeBot 的規則優先,因此日後若加上共同代號拒絕訓練,對 Anthropic 不會生效,仍須回頭修改 ClaudeBot 那一行。
中央社與 iThome 採用的 Content-Signal 也值得一提。它寫在萬用群組裡,依 Kelley 草案,不會被當成共同代號;兩站若要讓四家公司以新機制讀到拒絕訓練的偏好,需要另外加寫。
在台灣法律下,這個退出訊號有什麼意義?
在台灣,這行設定目前主要是表達立場,法律效果並不明確,因為台灣沒有歐盟那種以「保留權利」為前提的資料探勘例外。
歐盟 2019 年《數位單一市場著作權指令》第 4 條,對合法取得的作品設有文字與資料探勘例外,但線上公開的內容,權利人可以用機器可讀方式等適當方式保留權利,排除這項例外;Cloudflare 的內容訊號政策與 iThome 的 robots.txt 註解,都直接援引這一條。Google 在公告中也說,這次的做法與歐盟《人工智慧法》下通用 AI 模型行為準則一致,該準則把 robots.txt 視為出版商表達偏好的主要方式(本刊未能直接開啟準則原文核對)。
台灣的情況不同。今周刊 10 月 14 日報導,智慧財產局對 AI 與著作權議題表示仍須研究國際發展,是否調整法規仍在研議;台灣《著作權法》上次修正在 2022 年 6 月,早於 ChatGPT 問世。同一篇報導指出,數位發展部建立的主權 AI 訓練語料庫累計 7,161 筆資料,只有 111 筆來自民間;2025 年 7 月,一名台大博士生分享的繁體中文語料包含約 14 萬筆中央社新聞,中央社提出刑事告訴,雙方後來和解。
本刊認為,在沒有資料探勘例外的台灣,「選擇退出」機制的意義與歐盟相反。 在歐盟,權利人沒有保留權利,探勘原則上就落入例外,所以退出訊號是行使權利的關鍵。在台灣,未經授權的重製本來就可能構成侵權,退出訊號更像是一份公開聲明與證據。風險在於,如果業界習慣把「沒寫就是同意」當成預設——微軟的文件已經是這樣寫——台灣網站沒有加這一行,可能在談判或爭議中被解讀成默許。IETF 的 AIPREF 主席在 2025 年就說明過,偏好只是內容發布者的意願,本身不具法律強制力,也沒有技術強制,不能取代 AI 業者的盡職調查。
因此,對台灣網站而言,比較穩妥的做法是同時做兩件事:在 robots.txt 清楚表達偏好,並在網站使用條款寫明授權條件。聯合新聞網、報導者、iThome 已在 robots.txt 註解中寫入使用限制與授權聯絡方式,可作為參考。
台灣內容網站現在該怎麼設定?
先決定三個開關各要怎麼開,再寫規則,而不是先貼一行共同代號。
如果目標是「歡迎搜尋與 AI 引用、拒絕訓練」,一個符合目前各家文件的寫法如下:
# 抓取與回答:搜尋與 AI 搜尋用爬蟲維持開放
User-agent: Googlebot
User-agent: Bingbot
User-agent: OAI-SearchBot
User-agent: Claude-SearchBot
Allow: /
# 訓練:已知的訓練用代號逐一明寫
User-agent: GPTBot
User-agent: ClaudeBot
Disallow: /
# 訓練:共同代號,作為未具名業者的預設值
User-agent: __usage_ai-training
Disallow: /
User-agent: *
Allow: /
這份範例刻意沒有處理 Google-Extended,因為那是每個網站必須自己做的取捨:明寫 Allow: /,保留 Gemini 應用程式的回答來源,但也同意 Gemini 訓練;明寫 Disallow: / 或不寫而只靠共同代號,則訓練與 Gemini 應用程式的回答來源一起退出。依 Google 現行文件,Google-Extended 同時涵蓋兩者,本刊沒有查到能只拒絕訓練、保留 Gemini 回答來源的選項。
其他幾點實務提醒:
在意 Bing 的網站要注意期限。若網站過去用 NoArchive 或 NoCache 標籤限制 Bing 的 AI 用途,微軟說 2027 年 3 月 1 日後不再把它們視為訓練或依據偏好;要拒絕依據,須在頁面加上 Bingbot 的 ai-grounding 標籤,或在 Bing 站長工具登記暫時設定。
把 robots.txt 當版本化的設定檔管理。主席已建議改名,草案也可能被工作小組改寫成 Content-Usage 形式,代號在明年可能還會變。建議在 IETF 127 會後與 2027 年 2 月可能的期中會議後各檢查一次。
不要指望它擋住流量。共同代號不是抓取指令,伺服器負載與惡意爬蟲仍要靠封鎖具名爬蟲或防火牆處理。系統替使用者即時抓取頁面時,規則管不管得到背後的委託人,是本刊在〈AI Agent 的安全盲點〉討論過的同一類問題。
最後,記錄每次修改的日期。共同代號的效力依「抓取當時有效的 robots.txt」判斷,日後若有爭議,修改紀錄就是證據。這和本刊在〈AI 法規到期順序〉中提醒的合規準備邏輯相同:先留下可以證明的紀錄,再等規則定案。
接下來要看什麼?
接下來有三個觀察點。第一,OpenAI 何時公布具體實作方式,以及它如何處理 GPTBot 與共同代號衝突的情況。第二,IETF 工作小組最終是採納政策代號,還是把它併入 Content-Usage 寫法,代號名稱是否改變。第三,Google 2027 年上線時,是否把 Gemini 應用程式的回答與訓練拆成兩個開關。
在這三件事落定之前,這行 robots.txt 最好的定位是對尚未點名業者的預設聲明:它讓表達立場變容易了,但沒有讓設定變簡單。
|台灣科技週刊
資料與方法說明
本文的標準內容、時程與各家處理方式,以 IETF Datatracker 草案原文、IETF ai-control 郵件論壇原始信件、Google 搜尋中心部落格與爬蟲文件、微軟 Bing 部落格、Anthropic 說明中心、OpenAI 爬蟲文件為準。OpenAI 10 月 30 日的公告頁面本刊以工具開啟時遭拒(HTTP 403),其支援時程只能引用 Nieman Lab 與 SiliconANGLE 的轉述,屬未經原文核對的資訊;兩家媒體對時程的描述也不一致,SiliconANGLE 寫 OpenAI 與微軟「未來幾個月」、Google 明年,Nieman Lab 寫 Google 與微軟明年,微軟自家部落格則訂在 2027 年 2 月 1 日,本文以各公司自述為準。Anthropic「已開始實作」與「10 月 30 日起承認」均為公司自述,本刊無法從外部驗證實際執行情形。
台灣媒體 robots.txt 調查由本刊於 2026 年 11 月 13 日(台灣時間)以一般 HTTP 請求擷取 22 個主要新聞與科技媒體網站的 robots.txt,取得 19 份有效檔案,依 RFC 9309 的群組規則判讀是否有針對各代號的整站封鎖或允許。樣本為本刊選定的便利樣本,不代表所有台灣網站;網站可能另以防火牆或 CDN 規則封鎖爬蟲,robots.txt 無法反映;檔案隨時可能變更。
「共同代號可能連帶影響 Gemini 應用程式回答來源」是本刊依 Google 部落格與爬蟲文件推論,Google 尚未針對此情境提供說明。歐盟通用 AI 模型行為準則原文本刊未能開啟,相關描述來自 Google 公告的轉述。
參考資料
- IETF Datatracker,〈Machine-Readable Training Preference Signal(draft-kelley-aipref-training-preference-signal-00)〉,2026-10-30。
- Kevin Kelley,IETF ai-control 郵件論壇,〈New draft: draft-kelley-aipref-training-preference-signal-00〉,2026-10-30。
- Mark Nottingham,IETF ai-control 郵件論壇,〈Re: New draft: draft-kelley-aipref-training-preference-signal-00〉,2026-11-05。
- Alex Gibson,IETF ai-control 郵件論壇,〈Re: New draft: draft-kelley-aipref-training-preference-signal-00〉,2026-11-10。
- Angela Mills-Wade,IETF ai-control 郵件論壇,〈Re: New draft: draft-kelley-aipref-training-preference-signal-00〉,2026-11-12。
- Kevin Kelley,IETF ai-control 郵件論壇,〈Re: New draft: draft-kelley-aipref-training-preference-signal-00〉,2026-11-11(美西時間)。
- Nate Hake,IETF ai-control 郵件論壇,〈Re: New draft: draft-kelley-aipref-training-preference-signal-00〉,2026-11-03。
- IETF AIPREF 工作小組,〈IETF 127 議程〉,2026-11-06 擷取版本。
- IETF Datatracker,〈A Vocabulary For Expressing AI Usage Preferences(draft-ietf-aipref-vocab-08)〉,2026-09-13。
- IETF Datatracker,〈Associating AI Usage Preferences with Content in HTTP(draft-ietf-aipref-attach-05)〉,2026-08-18。
- Suresh Krishnan、Mark Nottingham,IETF 部落格,〈Progress on AI Preferences〉,2025-06-29。
- John Mueller,Google 搜尋中心部落格,〈Supporting a shared AI training control for websites〉,2026-10-30。
- Google 搜尋中心,〈Google's common crawlers〉,2026-11-13 擷取。
- Krishna Madhavan,微軟 Bing 部落格,〈Your content, your choice: clearer preferences for training and grounding〉,2026-10-30。
- Anthropic,Claude 說明中心,〈Does Anthropic crawl data from the web, and how can site owners block the crawler?〉,2026-11-13 擷取。
- OpenAI,〈Overview of OpenAI Crawlers〉,2026-11-13 擷取。
- Laura Hazard Owen,Nieman Lab,〈Anthropic, OpenAI, Google, and Microsoft will make it easier for publishers to opt out of being scraped〉,2026-11-02。
- Maria Deutscher,SiliconANGLE,〈Google, Anthropic and others to support new AI crawling opt-out standard〉,2026-10-30。
- Will Allen,Cloudflare 部落格,〈Giving users choice with Cloudflare’s new Content Signals Policy〉,2025-09-24。
- 歐盟,EUR-Lex,〈Directive (EU) 2019/790 on copyright and related rights in the Digital Single Market〉,2019-04-17。
- 陳子萱,今周刊,〈讓AI讀書算犯法?著作權法未鬆綁,主權AI訓練語料僅1%來自民間…台灣繁中語料庫難拓展制度哪卡關?〉,2026-10-14。