台灣科技週刊|半導體深度分析 資料查核截至:2026 年 11 月 13 日
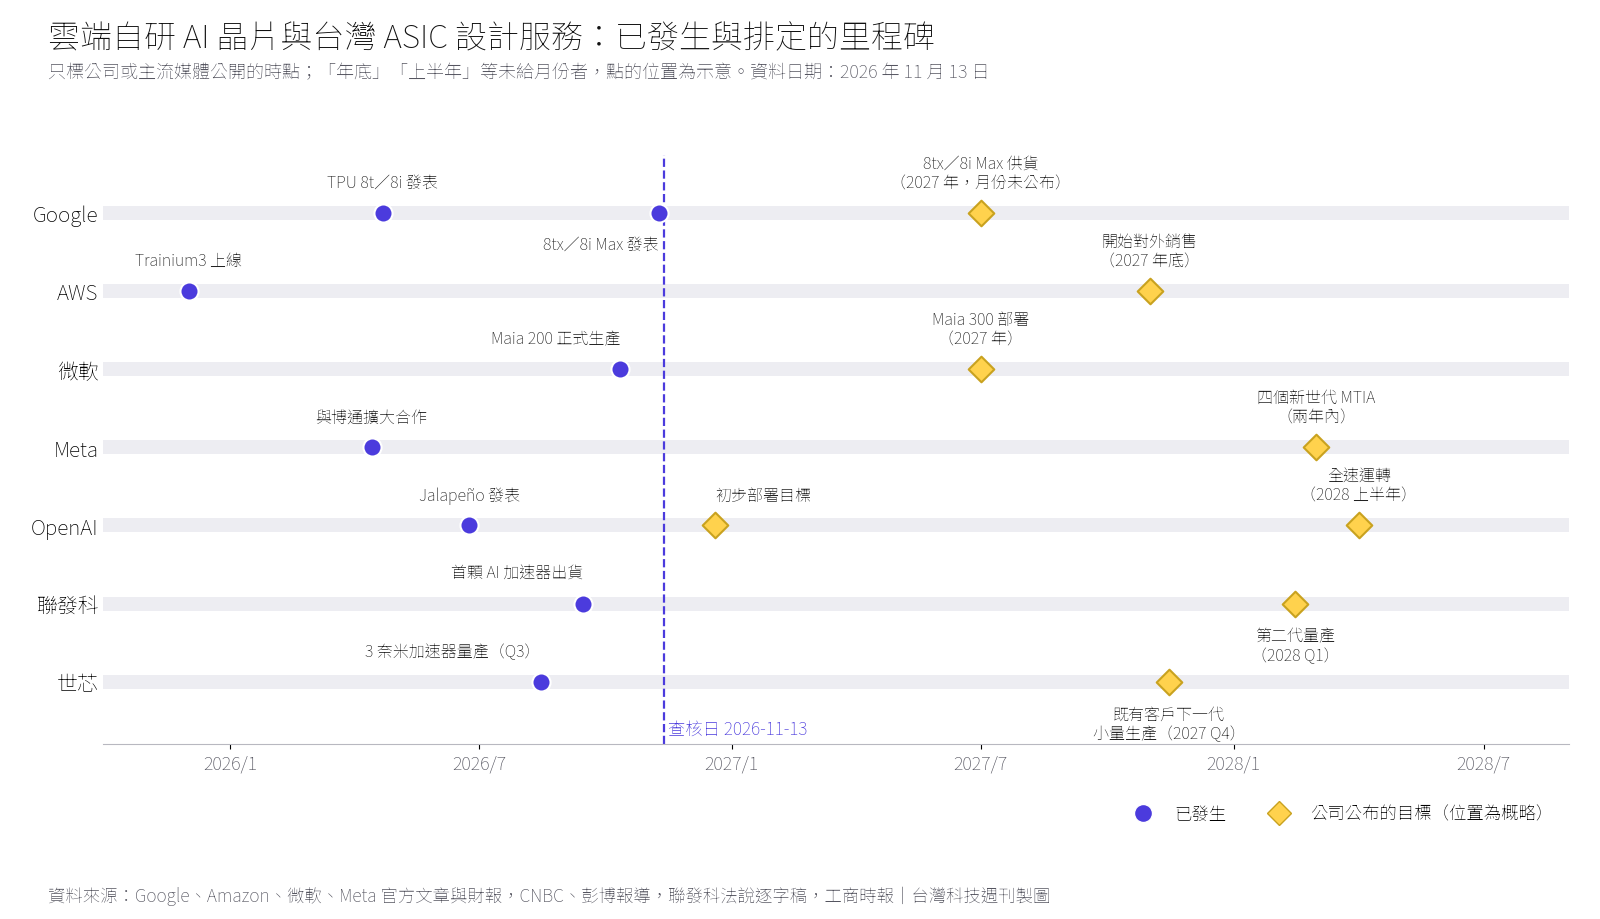
Google 在 11 月 9 日(美國時間)把第八代 TPU 從兩款擴充為四款系統:主打機密運算的 TPU 8tx,以及把兩顆 TPU 8i 封進同一個封裝的 TPU 8i Max。TPU(Tensor Processing Unit,張量處理器)是 Google 自行設計、專門跑 AI 運算的晶片。Google 晶片主管 Amin Vahdat 對彭博表示,兩款都不是全新晶片設計,而是依客戶需求重新配置,明年供貨;Google 官方文章沒有公布價格與上市日期。
這件事重要,原因不在規格本身。Google 用「不重新設計晶片、只改系統」的方式,在半年內多出兩款產品;同一時間,AWS 宣布 2027 年底開始對外賣 Trainium,微軟把 Maia 定為自家產品的主要推論系統,Meta 與 OpenAI 的自研晶片進入量產爬坡。這幾家公司的晶片多半出自同一家晶圓代工廠,而 AWS 執行長 Andy Jassy 在 10 月法說會上直說,每家都只拿得到一份配額。本刊認為,雲端自研晶片的競爭,接下來比的是怎麼分配那份配額,對輝達與台灣供應鏈的影響也要從這裡看。
TPU 8tx 與 TPU 8i Max 到底是什麼?
TPU 8tx 是 TPU 8t 的機密運算版本,TPU 8i Max 是兩顆 TPU 8i 的雙晶片封裝版本,兩者都沿用 4 月已發表的晶片。Google 在 4 月的 Cloud Next 大會推出第八代 TPU 的兩款晶片:負責大規模訓練的 TPU 8t,以及負責即時推論與推理的 TPU 8i。這次新增的兩款,Google 稱為「系統」而非「晶片」,Vahdat 在官方文章中特別區分兩者:晶片設計是以年計的製造流程,系統則是決定晶片周邊的運算、網路、儲存與封裝怎麼搭配。
機密運算(confidential computing)指資料在處理過程中仍維持加密與隔離,不只在儲存或傳輸時受保護。依 Google 說法,TPU 8tx 採用與 TPU 8t 相同的矽晶片,搭配第五代 AMD EPYC 處理器作為主機,在硬體層把資料與模型權重隔離;它也改用原本為 TPU 8i 設計的低延遲 Boardfly 網路,Google 自稱相較 TPU 8t 延遲最多降低一半,效能損失「接近零」。目標客戶是受監管的企業與政府,用途包括以私有資料微調模型、蒸餾與強化學習。值得注意的是,4 月發表的 TPU 8t 與 8i 都以 Google 自家 Arm 架構的 Axion 處理器當主機,8tx 改配 AMD,這是兩款新系統之間最明顯的硬體差異。
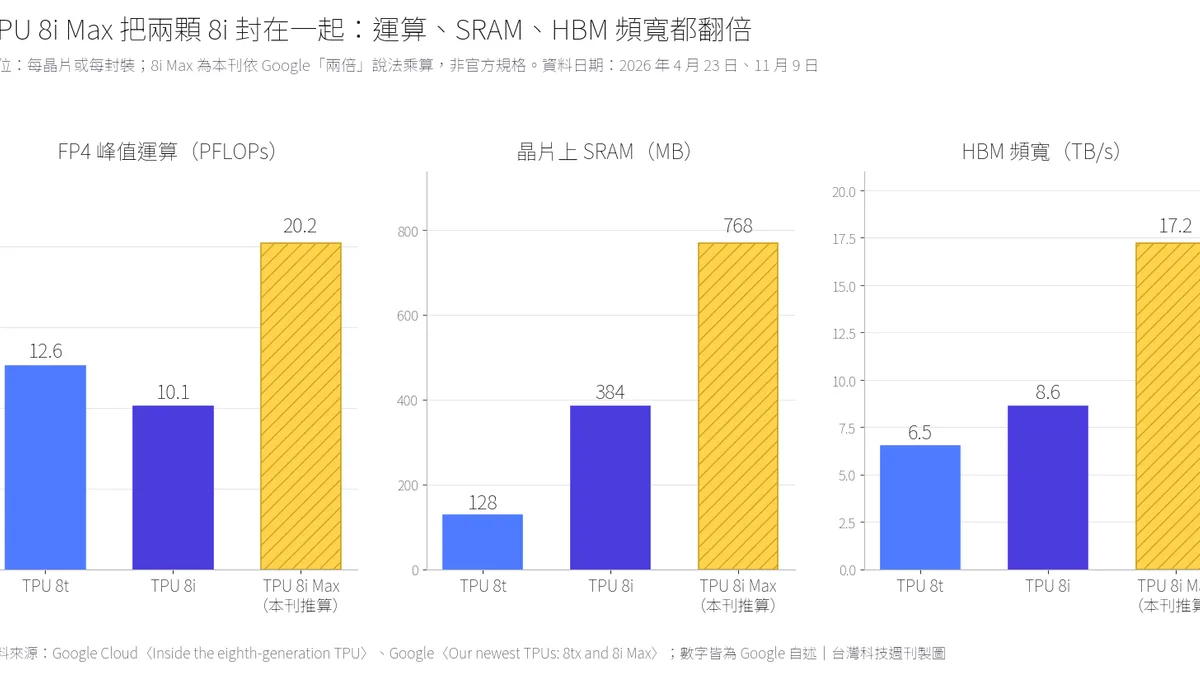
TPU 8i Max 針對的是「記憶體牆」:大型語言模型處理長上下文時,瓶頸常在記憶體頻寬而非運算力。Google 把兩顆 TPU 8i 放進同一個封裝,官方說法是運算力、晶片上 SRAM(靜態隨機存取記憶體,晶片內部的高速快取)與 HBM(高頻寬記憶體)頻寬都是 TPU 8i 的兩倍,並在既有機櫃空間內放進兩倍矽面積。Google 沒有說 HBM 容量是否也加倍。
|
系統 |
晶片來源 |
FP4 峰值運算 |
HBM 容量 |
HBM 頻寬 |
晶片上 SRAM |
主機處理器 |
定位 |
|---|---|---|---|---|---|---|---|
|
TPU 8t |
第八代訓練晶片 |
12.6 PFLOPs |
216 GB |
6,528 GB/s |
128 MB |
Arm Axion |
大規模預訓練 |
|
TPU 8i |
第八代推論晶片 |
10.1 PFLOPs |
288 GB |
8,601 GB/s |
384 MB |
Arm Axion |
低延遲推理、服務 |
|
TPU 8tx |
與 8t 相同矽晶片 |
未另公布 |
未另公布 |
未另公布 |
未另公布 |
第五代 AMD EPYC |
機密推論、小規模訓練 |
|
TPU 8i Max |
兩顆 8i 同封裝 |
約 20.2 PFLOPs(推算) |
未公布 |
約 17,202 GB/s(推算) |
約 768 MB(推算) |
未公布 |
長上下文、機櫃密度 |
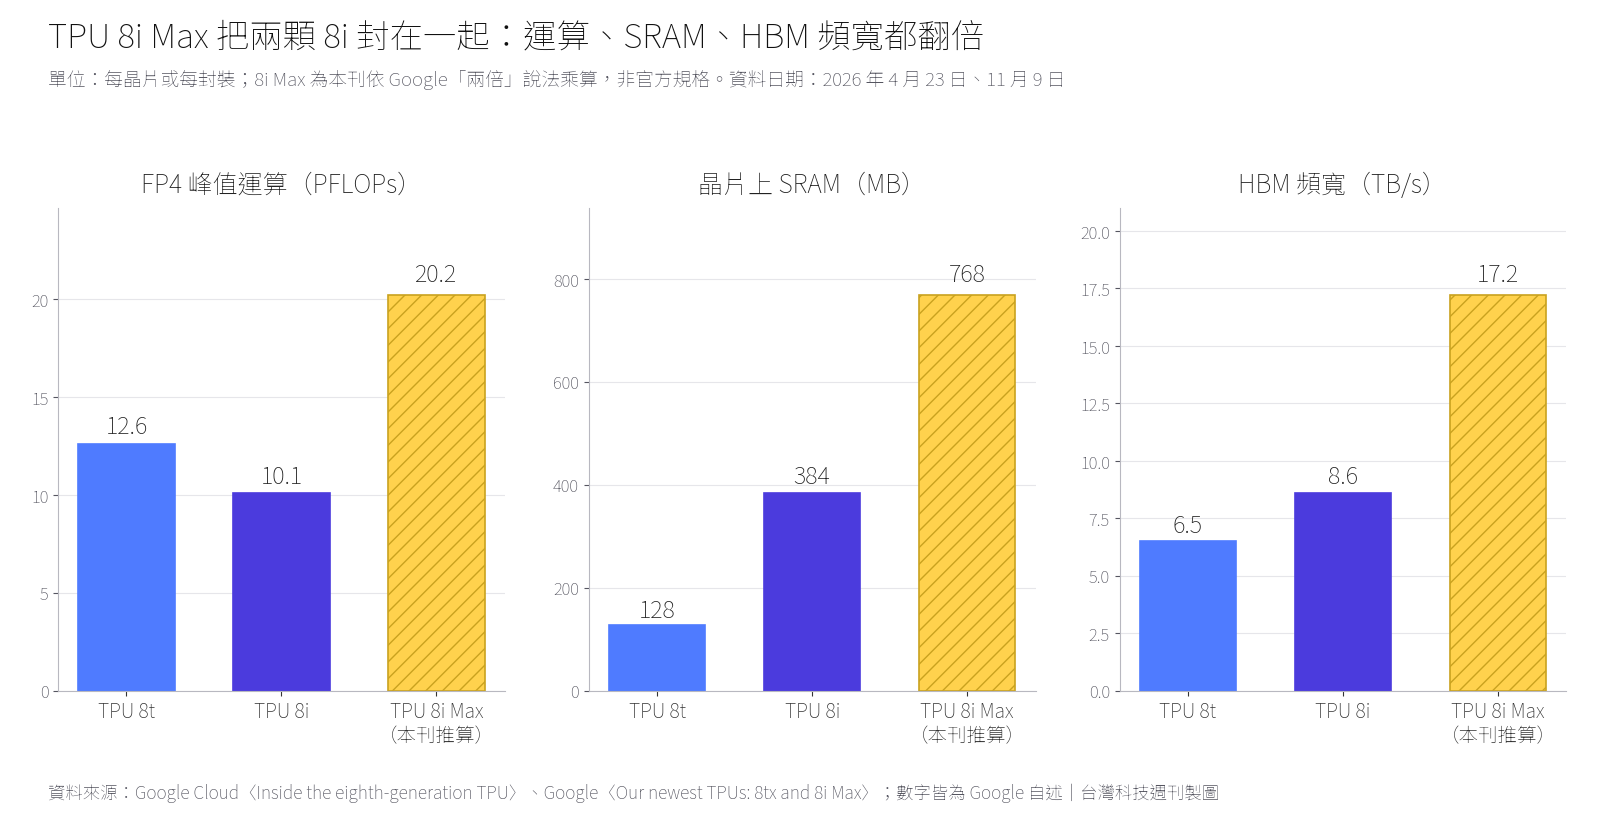
資料日期:TPU 8t、8i 規格取自 Google Cloud 2026 年 4 月 23 日技術文章;TPU 8tx、8i Max 說明取自 Google 2026 年 11 月 9 日文章。8i Max 數字為本刊依 Google「兩倍」說法乘算,不是官方規格。所有效能數字皆為 Google 自述,未經第三方驗證。
為什麼 Google 不做新晶片,只做新系統?
答案是速度與產能。新晶片從設計到量產要以年計,換封裝、換主機、換網路拓撲只要幾個月,Vahdat 在文中說,模組化設計讓 Google 能在「幾個月而非幾年」內交付特製超級電腦。Google 也強調,這是它第一次在同一年推出四款 TPU 系統。
產能面的壓力同樣明顯。彭博引述 Google 財報指出,Google 可供應的 TPU 都已經簽給客戶,而且與整個產業一樣面臨記憶體與製造產能短缺。在這種情況下,不必重新下線(tape-out,把設計交付晶圓廠投片)就能多出新產品,等於用同一批已驗證的晶片,切出更多可以賣的品項。本刊認為,這是 TPU 8tx 與 8i Max 最值得注意的商業意義:Google 把產品差異化從晶圓廠前端,移到封裝與系統整合的後端。
不過「同一顆晶片」不代表不吃新產能。TPU 8i Max 把兩顆晶片封在一起,每個封裝耗用的先進封裝與 HBM 資源都比單顆 8i 多;8tx 雖然沿用 8t 晶片,搭配的卻是 AMD 處理器而非自家 Axion。換句話說,Google 改變的是配額的用法,而不是逃離配額。
Google 的 TPU 現在賣給誰?
依 Google 與彭博的公開說法,TPU 已經不只用在 Google 自己身上。Vahdat 在 11 月 9 日的文章中列出四種用途:訓練與服務自家 Gemini 模型、代理型 AI 工作負載、透過 Google Cloud 出租給客戶,以及最新的「讓客戶把 TPU 直接部署在自己的資料中心」,並稱 TPU 客戶已接近 100 家。
彭博同一天的報導補充了客戶名單與交易規模:蘋果、Meta 與甲骨文都是 TPU 客戶;甲骨文上月宣布明年起讓自家雲端客戶使用 TPU;Anthropic 依最近一份監管文件,擁有在 2028 至 2031 年間購買最多 1,500 億美元 TPU 的選擇權;彭博也曾報導 OpenAI 計畫採購 TPU。彭博行業研究(Bloomberg Intelligence)估計,TPU 相關銷售今年約 120 億美元,2028 年將超過 1,350 億美元,這是研究機構的預估,不是 Google 揭露的數字。Anthropic 的資本與上市脈絡,可參考本刊〈Anthropic IPO〉一文。
AWS、微軟、Meta 與 OpenAI 的自研晶片走到哪裡?
四家都在量產或接近量產,但只有 AWS 公開宣布要對外銷售,時間是 2027 年底。以下逐一整理一手資料。
AWS 的 Trainium3 在 2025 年 12 月正式上線,是 AWS 第一顆 3 奈米 AI 晶片,Trn3 UltraServer 單一系統最多 144 顆,FP8 運算最高 362 PFLOPs;下一代 Trainium4 已在開發,AWS 表示將支援輝達的 NVLink Fusion 互連技術。Amazon 10 月 29 日公布第三季財報,Jassy 在法說會上說,晶片業務營收仍以三位數百分比年增,Graviton 與 Trainium 的營收承諾各自年增超過 20 倍,Bedrock 上的模型服務多數跑在 Trainium 上,並宣布 2027 年底開始對外銷售 Trainium。
微軟 10 月 12 日宣布 Maia 200 已進入正式生產,服務 Microsoft Copilot 等產品,在美國、歐洲與澳洲部署,跑的模型包括 OpenAI 模型、微軟自家 MAI 模型與開源模型;微軟自稱在內建 AI 功能上每瓦產出的 token 數最多是主流 GPU 的 1.7 倍。下一代 Maia 300 預計 2027 年開始正式部署,運算小晶片採台積電 N2P 製程,搭配 8 組 HBM4、單晶片 18.0 TB/s 記憶體頻寬、950 瓦熱設計功耗,一個機櫃 96 顆加速器、功率 167 千瓦。微軟說 Maia 將成為「微軟產品與服務的主要推論系統」,沒有提到對外銷售。
Meta 4 月 14 日宣布與博通(Broadcom)擴大合作,共同開發多個世代的 MTIA(Meta 訓練與推論加速器),第一階段承諾超過 1 GW,之後擴大到多個 GW;CNBC 引述博通說法,MTIA 將是第一款採 2 奈米製程的 AI 晶片。Meta 表示要在兩年內開發並部署四個新世代 MTIA。CNBC 指出,MTIA 完全供 Meta 內部使用。
OpenAI 6 月 24 日與博通發表第一顆合作晶片 Jalapeño,用於推論。依 CNBC 報導,雙方目標是 2026 年底前初步部署;博通執行長陳福陽(Hock Tan)說,2026 年底是小規模原型,2027 年開始放量,2028 上半年全速運轉。
|
公司 |
最新公開晶片 |
最新狀態(截至 2026-11-13) |
公開的製程或合作方 |
自用 |
雲端出租 |
對外銷售 |
|---|---|---|---|---|---|---|
|
|
TPU 8t、8i、8tx、8i Max |
8tx、8i Max 據 Vahdat 明年供貨 |
博通協助設計並安排生產(彭博) |
是 |
是 |
是,已有客戶自建機房部署 |
|
AWS |
Trainium3、Trainium4(開發中) |
Trn3 自 2025-12 上線 |
Trainium3 為 3 奈米(AWS 未具名代工廠) |
是 |
是 |
2027 年底開始 |
|
微軟 |
Maia 200、Maia 300 |
Maia 200 正式生產;Maia 300 於 2027 年部署 |
Maia 300 運算小晶片採台積電 N2P |
是 |
未公布 |
未公布 |
|
Meta |
MTIA 新世代 |
兩年內部署四個新世代 |
博通;2 奈米(博通說法) |
是 |
否 |
否 |
|
OpenAI |
Jalapeño |
目標 2026 年底初步部署 |
博通 |
是 |
未公布 |
未公布 |
資料日期:2026 年 11 月 13 日查核。依各公司官方文章、財報與法說,以及彭博、CNBC 報導整理;「未公布」表示本刊未找到公開說法,不代表沒有。
什麼是「配額三岔路」?
「配額三岔路」是本刊用來比較雲端自研晶片策略的框架:一家公司拿到的每一份先進製程晶圓、先進封裝與 HBM 配額,最後只會走三條路之一。第一條是自用,跑自家的搜尋、社群、Copilot 或模型訓練;第二條是出租,以雲端執行個體或模型服務的形式按用量收費;第三條是外賣,把晶片或整套系統賣進客戶自己的機房。
這個框架的根據,來自 Jassy 在 Amazon 第三季法說會上的說法。他指出,同時擁有大型雲端業務、又有強到能對外賣的晶片的公司,「實際上只有兩家」;大家的先進晶片都在同一家供應商生產,每家拿到一份配額,必須決定多少對外賣、多少留在自家雲端。他也講出兩條路的取捨:對外賣可以在晶片出庫時立刻認列營收,留在雲端則能在五到六年的使用期間累積更多營收與自由現金流。Jassy 沒有點名那家供應商;以 Maia 300 公開採用台積電製程、以及台積電自稱「所有 AI 業者都與台積電合作」來看,本刊判斷指的應是台積電。
用三岔路檢視上表,可以得到三個判斷。
第一,Google 是目前唯一三條路都公開在走的公司。TPU 8tx 瞄準受監管的企業與政府,8i Max 則把機櫃密度當賣點,兩者都更像為「外賣」與「出租」設計的產品,而不只是內部需求。
第二,AWS 已經把第三條路排進時程,但選擇先把配額留在自家雲端。Jassy 說 AWS 過去使用晶片的方式與「另一家」不同,並表示每年都會重新評估外賣與自用的比例。本刊認為,2027 年底之後,市場上會出現兩家同時在雲端出租、又在對外銷售自研晶片的雲端業者。
第三,微軟、Meta 與 OpenAI 目前公開的都是自用路線。這三家的自研晶片會減少它們向外採購的需求,但不直接在公開市場和輝達搶客戶。
三岔路還有一個關鍵前提:配額不能轉手。台積電董事長魏哲家在 10 月 15 日法說會上回答分析師時說,台積電原則上不允許客戶轉租或拍賣產能,只在少數情況下透過光罩授權合作,量非常小。本刊認為,這讓每家公司的分配決定更具約束力:配額一旦拿到,就只能在自己的三條路之間切,沒有二手市場可以調節。
這對輝達代表什麼?
對輝達來說,自研晶片真正的直接競爭集中在第三條路,也就是對外銷售;而這條路目前只有 Google 在走,AWS 要到 2027 年底才加入。前兩條路的影響是間接的:雲端業者自用與出租的比例越高,向輝達採購的增量就可能越少,但公開資料並沒有顯示需求下滑。彭博在 11 月 9 日的報導中寫道,輝達 AI 處理器的需求仍大於供給。
價格是 TPU 外賣的主要賣點。彭博行業研究分析師 Mandeep Singh 估計,TPU 的成本比輝達 GPU 低約 30%,處理量具競爭力,但 TPU 的利潤率不如輝達。這是分析師估計,不是兩家公司公布的數字。輝達也在調整產品線,彭博指出它開始提供自家 CPU,以及採用收購自 Groq 技術的推論晶片。AWS 的 Trainium4 則設計成支援輝達 NVLink Fusion,顯示輝達的互連技術也可能出現在對手的自研系統裡。
輝達本身正處於領導層交接期。依輝達 11 月 12 日向美國證管會提交的 8-K 文件,黃仁勳即日起辭去總裁、執行長與董事職務,財務長 Colette Kress 出任暫代執行長並續任財務長,董事會任命 Harvey C. Jones 為首任董事長,並展開正式執行長的遴選。董事會表示預期公司營運、對客戶的承諾與產品路線圖不受影響。輝達第三財季財報仍按原訂時間於美國時間 11 月 17 日公布,屆時是外界觀察需求與供應狀況的下一個一手資料點。本文不評論交接原因,也不對股價做任何判斷。
台灣供應鏈從自研晶片賺到什麼?
台灣供應鏈從三個環節受益:晶圓代工、ASIC 設計服務與先進封裝,但三者拿到的毛利差距很大。ASIC(特殊應用積體電路)是為特定客戶、特定用途設計的晶片;ASIC 設計服務公司替雲端業者把架構變成可量產的晶片,並代為安排投片與封裝。
代工端,台積電第三季高效能運算平台占營收 68%,季增 22%,毛利率 66.4%。魏哲家在法說會上說,需求仍高於供給,先前給的 AI 加速器 2024 至 2029 年營收年複合成長率「中到高 50%」區間,「可能會更高」;2 奈米家族產能預計 2027 年增加一倍以上,未來數年在台灣興建 13 座先進製程與先進封裝廠。先進封裝方面,他說 CoWoS 仍是客戶首選,但也承認競爭對手提供了很有競爭力的方案。
設計服務端,聯發科在 10 月 30 日法說會上說,第一顆 AI 加速器 9 月開始出貨,第四季營收目標 25 億美元,2027 年可望達到約 160 億美元目標區間的高標,相當於 AI 加速器 ASIC 市場約兩成;第二代產品預計 2028 年第一季大量生產,第二個客戶的營收也從 2028 年開始。聯發科沒有點名客戶;彭博報導提到有消息指聯發科參與 Google 的 TPU 業務,Vahdat 不予置評。聯發科也說,第三季完成 39 億美元海外可轉換公司債發行,輝達與 Alphabet 都有參與認購。世芯 11 月 6 日法說會則公布第三季營收 8.2 億美元,季增 238.9%,3 奈米 AI 加速器第三季大量生產,北美營收占比從第二季的 51% 升到 84%,既有客戶的下一代加速器本季陸續投片,目標 2027 年第四季小量生產、2028 年放量,公司並預期 2027 年營收三位數成長;世芯同樣未具名客戶。
封裝端的變化值得注意。聯發科執行長蔡力行在法說會上說,第二代 ASIC 正與一家美國整合元件製造商(IDM)合作封裝製程,並與日本、台灣供應商合作提升良率。公司沒有說出 IDM 名稱。本刊認為,這代表先進封裝不再必然只走台灣一條路,台灣供應鏈的機會與風險同時存在。先進封裝與光學互連的產能時程,可參考本刊〈CPO 量產四鐘〉。
用三岔路來看,台灣業者的位置是「配額的上游」:不論晶片最後被自用、出租或外賣,都要先經過晶圓、封裝與記憶體這幾道關卡。但價值分配並不平均。世芯第三季毛利率降到兩成以下,公司說原因是晶圓、載板與封裝產能短缺,以及部分設計服務收入遞延認列,若無供應限制,第三季營收原可多約 1 億美元;聯發科也預期資料中心業務會稀釋毛利率。本刊認為,ASIC 設計服務以營收規模換取市場位置,掌握產能的代工廠與記憶體廠握有較強的議價力。記憶體廠在 AI 擴張中的毛利結構,可參考本刊〈記憶體毛利與排擠租〉。
接下來要看哪些訊號?
本刊建議追蹤四個可以查證的時間點,用來檢驗三岔路的判斷。第一是輝達 11 月 17 日的財報,看資料中心需求與供應描述是否改變。第二是 TPU 8tx 與 8i Max 在 2027 年的實際供貨日期與首批客戶,特別是有沒有政府或金融業者公開採用。第三是 AWS 在 2027 年底開始外賣 Trainium 時,公布的第一批客戶與交貨規模。第四是台積電 2 奈米與先進封裝產能在 2027 年的擴充幅度,以及聯發科、世芯的新世代產品能否按時在 2027 年底至 2028 年量產。
雲端業者的資本支出承諾與電力限制,是三岔路之外的另一組變數,可分別參考本刊〈四大廠算力承諾〉與〈資料中心通電三權〉。本刊的判斷是:2027 年將是雲端自研晶片從「自用為主」轉向「出租與外賣並進」的一年,而決定轉向速度的,不是誰的晶片設計得最好,而是誰的配額最多、分得最精。
|台灣科技週刊
資料與方法說明
本文依 Google、Amazon、微軟、Meta、輝達的官方文章與美國證管會文件,台積電、聯發科與 Amazon 的法說逐字稿,以及彭博、CNBC、工商時報報導寫成。所有晶片規格、效能倍數與部署時程,除另有標示外皆為公司自述,本刊未做實測,也未進行訪談。「配額三岔路」與文中標示「本刊認為」「本刊判斷」之處為本刊分析;TPU 8i Max 的運算、SRAM 與頻寬數字為本刊依 Google「兩倍」說法推算,不是官方規格。
以下幾點未能驗證或需保留:TPU 8tx 與 8i Max「明年供貨」只見於彭博引述 Vahdat,Google 官方文章未提上市時間與價格;Anthropic 最多 1,500 億美元 TPU 選擇權與 OpenAI 採購 TPU 的消息,本刊只看到彭博的轉述,未打開原始監管文件;聯發科與 TPU 的關係僅為彭博所稱「有報導指出」,部分媒體稱聯發科負責 TPU 8i、另有媒體稱是 TPU 8t,兩說矛盾,本文未採用;Jassy 所說的「同一家供應商」未具名,指台積電是本刊推論;台積電與聯發科法說內容比對的是 Webull 與 StockAnalysis 的逐字稿,不是公司官方版本;世芯法說內容取自工商時報報導,未取得公司簡報;Meta 的 MTIA 2 奈米說法出自 CNBC 轉述博通新聞稿,博通新聞稿頁面本刊無法開啟。本文內容不構成投資建議。
參考資料
- Google(Amin Vahdat),〈Our newest TPUs: 8tx and 8i Max, built for the agentic era〉,2026-11-09。
- Google Cloud,〈Introducing TPU 8tx and TPU 8i Max〉,2026-11-10。
- Google Cloud,〈Inside the eighth-generation TPU: An architecture deep dive〉,2026-04-23。
- Google,〈Our eighth generation TPUs: two chips for the agentic era〉,2026-04-22。
- Bloomberg(Yahoo Finance 轉載),〈Google Escalates Nvidia Rivalry With Specialized Versions of AI Chips〉,2026-11-09。
- Amazon(SEC Form 8-K),〈Amazon.com Announces Third Quarter Results〉,2026-10-29。
- The Motley Fool,〈Amazon (AMZN) Q3 2026 Earnings Call Transcript〉,2026-10-30。
- Amazon,〈Trainium3 UltraServers now available: Enabling customers to train and deploy AI models faster at lower cost〉,2025-12-02。
- Microsoft(Scott Guthrie),〈Microsoft to expand Azure Maia system to multi-gigawatt deployments〉,2026-10-12。
- Meta,〈Meta Partners With Broadcom to Co-Develop Custom AI Silicon〉,2026-04-14。
- CNBC,〈Meta commits to 1 gigawatt of custom chips with Broadcom as Hock Tan decides to leave board〉,2026-04-14。
- CNBC,〈OpenAI unveils first chip as part of Broadcom deal in effort to 'build the full stack'〉,2026-06-24。
- NVIDIA(SEC Form 8-K 附件 99.1),〈NVIDIA Announces CEO Transition〉,2026-11-12。
- Webull,〈TSMC (TSM) Q3 2026 Earnings Call Transcript〉,2026-10-15。
- StockAnalysis,〈MediaTek (TPE:2454) Q3 2026 Earnings Call Transcript〉,2026-10-30。
- 工商時報,〈世芯 明年營收衝翻倍成長〉,2026-11-07。